library(haven)
library(dplyr)
library(ggplot2)
library(ggrepel)

base <- readRDS("cdf_casen2024_simulada.rds")🧪 Taller semana 10: reporte de terreno con códigos de disposición en R
Descarga: 📄 base cdf_casen2024_simulada.rds
La base
Es una base simulada: ningún registro corresponde a una vivienda real. Emula la base de disposición final de casos de la Casen 2024, con una fila por vivienda seleccionada. Se construyó para que reproduzca las cifras publicadas en el Documento metodológico del proceso estadístico Casen 2024 del Observatorio Social: el total de viviendas seleccionadas, las viviendas logradas y las tasas por región y área, el avance semanal y la duración de la entrevista. El resto (fechas de cada caso, visitas, encuestadoras, UPM y códigos detallados) se simuló.
La base viene en formato .rds y sus variables tienen etiquetas: el código de disposición final trae la glosa de cada código, y la región y el área sus nombres.
| Variable | Descripción |
|---|---|
folio |
Identificador de la vivienda (ficticio) |
region |
Región, numerada de norte a sur (1 = Arica y Parinacota, 16 = Magallanes) |
area |
Urbano o Rural |
cod_upm |
Unidad primaria de muestreo (ficticia) |
cdf |
Código de disposición final |
fecha_cdf, semana |
Fecha del resultado final y semana de terreno (viernes a jueves, desde el 1 de noviembre de 2024) |
n_visitas |
Visitas realizadas hasta cerrar el caso |
id_encuestador |
Encuestadora que cerró el caso (ficticia) |
n_personas, duracion_min |
Solo para entrevistas logradas: integrantes del hogar y duración en minutos |
Las viviendas sin gestión (códigos 510 y 520) no tienen fecha, visitas ni encuestadora.
Paso 0. Antes del taller
install.packages(c("haven", "dplyr", "ggplot2", "ggrepel"))- Crear un proyecto de RStudio: File > New Project > New Directory > New Project, con un nombre como
taller10. RStudio crea una carpeta con un archivo.Rproj; trabajar dentro del proyecto hace que R encuentre los archivos de esa carpeta sin escribir rutas completas. - Descargar la base y guardarla en la carpeta del proyecto. Abrir el proyecto (doble clic en el archivo
.Rproj) y crear un script nuevo (File > New File > R Script) para ir copiando el código de esta guía.
Si algo falla, vengan igual: se puede trabajar en parejas.
Paso 1. Cargar y mirar la base
glimpse(base)Rows: 112,448
Columns: 11
$ folio <dbl> 100001, 100002, 100003, 100004, 100005, 100006, 100007,…
$ region <int+lbl> 6, 3, 14, 16, 7, 16, 7, 10, 8, 1, 7, 7, 5, 5, 14, 1…
$ area <int+lbl> 1, 1, 2, 1, 1, 1, 1, 2, 1, 1, 1, 1, 1, 1, 1, 1, 1, …
$ cod_upm <dbl> 61129, 30564, 140598, 160027, 70592, 160028, 70886, 100…
$ cdf <int+lbl> 110, 110, 110, 110, 110, 224, 110, 110, 110, 110, 1…
$ fecha_cdf <date> 2024-11-01, 2024-11-15, 2024-12-06, 2024-12-07, 2025-0…
$ semana <int> 1, 3, 6, 6, 12, 2, 12, 3, 8, 3, 7, 5, 1, 12, 3, 1, 2, 6…
$ n_visitas <int> 1, 4, 3, 1, 1, 4, 1, 1, 1, 4, 2, 1, 6, 2, 3, 3, 3, 3, 1…
$ id_encuestador <chr> "ENC0337", "ENC0378", "ENC0937", "ENC1456", "ENC1259", …
$ n_personas <int> 1, 3, 1, 4, 3, NA, 3, 2, 5, 4, 1, 4, 1, 2, 4, 2, 2, NA,…
$ duracion_min <int> 36, 51, 34, 101, 57, NA, 51, 102, 116, 60, 61, 19, 44, …La función as_factor() de haven muestra las etiquetas en vez de los números:
base |>
count(cdf = as_factor(cdf))| cdf | n |
|---|---|
| 110. Entrevista completa | 77618 |
| 211. Se rechazó la entrevista | 8552 |
| 212. Se interrumpió la entrevista | 1204 |
| 223. Se impidió acceso a la vivienda | 2839 |
| 224. Vivienda ocupada sin moradores presentes | 8446 |
| 225. Informante no ubicable o no puede atender | 3411 |
| 231. Muerte del informante | 22 |
| 232. Informante impedido físico o mental para contestar | 174 |
| 233. Problemas de idioma | 37 |
| 236. Otra razón, elegible | 176 |
| 317. Área peligrosa o de difícil acceso | 655 |
| 318. No fue posible localizar la dirección | 888 |
| 390. Otra razón, elegibilidad desconocida | 753 |
| 451. Empresa, oficina de gobierno u otra organización | 223 |
| 452. Institución (hospital, cárcel, asilo, etc.) | 56 |
| 453. Dormitorio colectivo | 50 |
| 454. Vivienda en demolición, incendiada o destruida | 321 |
| 461. Vivienda particular desocupada | 3465 |
| 462. Vivienda de veraneo o de uso temporal | 1375 |
| 463. Otra razón, no elegible | 495 |
| 510. Asignada sin gestión | 361 |
| 520. No asignada | 1327 |
Paso 2. Agrupar los códigos
Cada código se asigna a una categoría según el esquema de la clase:
| Categoría | Códigos |
|---|---|
| Entrevistada (E) | 110 |
| Rechazo (R) | 211, 212 |
| No contacto (NC) | 223, 224, 225 |
| Otras no entrevistadas (O) | 231, 232, 233, 236 |
| Elegibilidad desconocida (ED) | 317, 318, 390 |
| No elegible (NE) | 451 a 463 |
| Sin gestión (SG) | 510, 520 |
base <- base |>
  mutate(grupo = case_when(
    cdf == 110                     ~ "E",
    cdf %in% c(211, 212)           ~ "R",
    cdf %in% c(223, 224, 225)      ~ "NC",
    cdf %in% c(231, 232, 233, 236) ~ "O",
    cdf %in% c(317, 318, 390)      ~ "ED",
    cdf >= 451 & cdf <= 463        ~ "NE",
    cdf %in% c(510, 520)           ~ "SG"
  ))
Paso 3. La tabla de disposición final
base |>
  count(grupo) |>
mutate(porcentaje = round(100 * n / sum(n), 1))| grupo | n | porcentaje |
|---|---|---|
| E | 77618 | 69.0 |
| ED | 2296 | 2.0 |
| NC | 14696 | 13.1 |
| NE | 5985 | 5.3 |
| O | 409 | 0.4 |
| R | 9756 | 8.7 |
| SG | 1688 | 1.5 |
Paso 4. Las tasas nacionales
Primero se cuentan las categorías en una sola fila, y después se calculan las tasas:
conteo <- base |>
  summarise(
    total = n(),
    E  = sum(grupo == "E"),
    R  = sum(grupo == "R"),
    NC = sum(grupo == "NC"),
    O  = sum(grupo == "O"),
    ED = sum(grupo == "ED"),
    NE = sum(grupo == "NE")
  )

conteo |>
  transmute(
    respuesta    = round(E / (E + R + NC + O + ED), 3),
    contacto     = round((E + R + O) / (E + R + NC + O + ED), 3),
    cooperacion  = round(E / (E + R + O), 3),
    rechazo      = round(R / (E + R + NC + O + ED), 3),
    elegibilidad = round((E + R + NC + O) / total, 3)
)| respuesta | contacto | cooperacion | rechazo | elegibilidad |
|---|---|---|---|---|
| 0.741 | 0.838 | 0.884 | 0.093 | 0.911 |
Son las cifras nacionales publicadas para la Casen 2024.
Ahora las tres versiones de la tasa de respuesta de AAPOR. La e se estima como la proporción de elegibles entre los casos cuya elegibilidad se conoce:
conteo |>
  transmute(
    e   = round((E + R + NC + O) / (E + R + NC + O + NE), 3),
    RR1 = round(E / (E + R + NC + O + ED), 3),
    RR3 = round(E / (E + R + NC + O + e * ED), 3),
    RR5 = round(E / (E + R + NC + O), 3)
)| e | RR1 | RR3 | RR5 |
|---|---|---|---|
| 0.945 | 0.741 | 0.742 | 0.757 |
¿Cuánto cambia la tasa según el supuesto sobre los casos de elegibilidad desconocida? ¿Por qué en este caso la diferencia es pequeña?
Paso 5. Tasas por área y región
El mismo cálculo, agrupado. Con as_factor() la tabla muestra los nombres de las regiones:
tasas_region <- base |>
  group_by(region = as_factor(region)) |>
  summarise(
    E  = sum(grupo == "E"),
    R  = sum(grupo == "R"),
    NC = sum(grupo == "NC"),
    O  = sum(grupo == "O"),
    ED = sum(grupo == "ED")
  ) |>
  mutate(
    respuesta   = round(100 * E / (E + R + NC + O + ED), 1),
    contacto    = round(100 * (E + R + O) / (E + R + NC + O + ED), 1),
    cooperacion = round(100 * E / (E + R + O), 1),
    rechazo     = round(100 * R / (E + R + NC + O + ED), 1)
  )

tasas_region| region | E | R | NC | O | ED | respuesta | contacto | cooperacion | rechazo |
|---|---|---|---|---|---|---|---|---|---|
| Arica y Parinacota | 2753 | 447 | 363 | 12 | 56 | 75.8 | 88.5 | 85.7 | 12.3 |
| Tarapacá | 3055 | 311 | 961 | 29 | 151 | 67.8 | 75.3 | 90.0 | 6.9 |
| Antofagasta | 3401 | 424 | 982 | 27 | 153 | 68.2 | 77.2 | 88.3 | 8.5 |
| Atacama | 3214 | 391 | 850 | 11 | 133 | 69.9 | 78.6 | 88.9 | 8.5 |
| Coquimbo | 3583 | 599 | 391 | 13 | 61 | 77.1 | 90.3 | 85.4 | 12.9 |
| Valparaíso | 8345 | 1009 | 1347 | 54 | 210 | 76.1 | 85.8 | 88.7 | 9.2 |
| Metropolitana | 13787 | 3165 | 3634 | 90 | 568 | 64.9 | 80.2 | 80.9 | 14.9 |
| O’Higgins | 5264 | 314 | 824 | 16 | 129 | 80.4 | 85.4 | 94.1 | 4.8 |
| Maule | 5469 | 547 | 690 | 15 | 108 | 80.1 | 88.3 | 90.7 | 8.0 |
| Ñuble | 3469 | 306 | 442 | 28 | 69 | 80.4 | 88.2 | 91.2 | 7.1 |
| Biobío | 8060 | 759 | 1208 | 38 | 189 | 78.6 | 86.4 | 91.0 | 7.4 |
| La Araucanía | 5447 | 437 | 1086 | 18 | 170 | 76.1 | 82.5 | 92.3 | 6.1 |
| Los Ríos | 3414 | 326 | 466 | 15 | 73 | 79.5 | 87.4 | 90.9 | 7.6 |
| Los Lagos | 4263 | 398 | 535 | 29 | 83 | 80.3 | 88.4 | 90.9 | 7.5 |
| Aysén | 1751 | 122 | 231 | 3 | 36 | 81.7 | 87.5 | 93.3 | 5.7 |
| Magallanes | 2343 | 201 | 686 | 11 | 107 | 70.0 | 76.3 | 91.7 | 6.0 |
Repitan el cálculo agrupando por as_factor(area). Después grafiquen contacto contra cooperación. geom_text_repel(), del paquete ggrepel, evita que los nombres se superpongan:
ggplot(tasas_region, aes(contacto, cooperacion, label = region)) +
  geom_point(color = "#0A3564", size = 2.5) +
  geom_text_repel(size = 3) +
  labs(x = "Tasa de contacto (%)", y = "Tasa de cooperación (%)") +
  theme_minimal()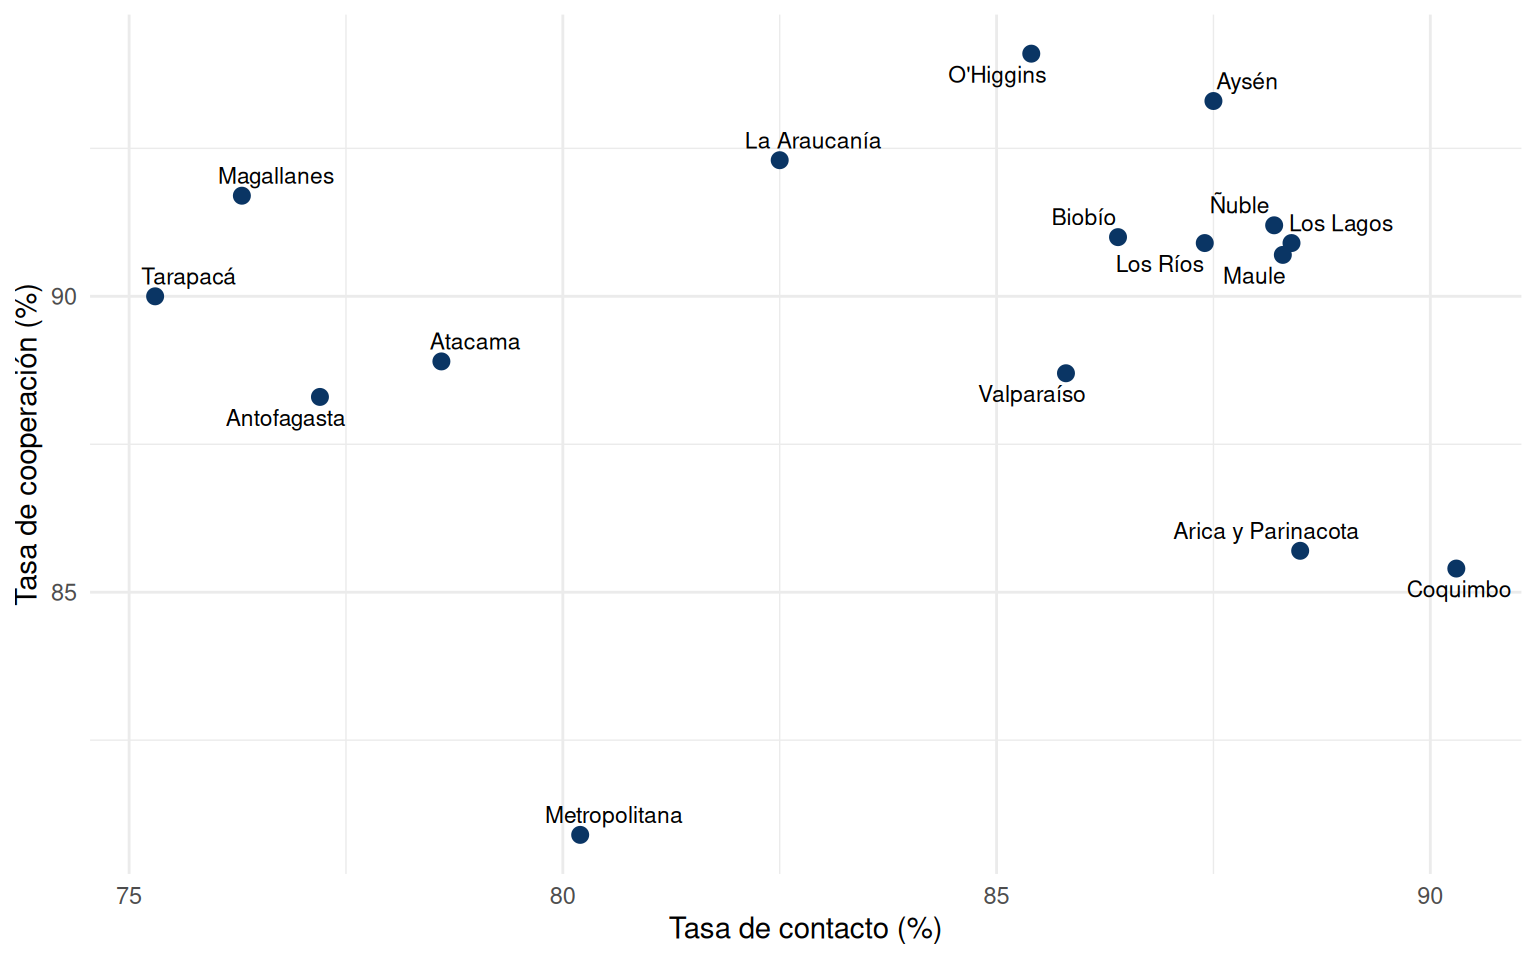
¿En qué regiones el problema es encontrar a las personas, y en cuáles convencerlas?
Paso 6. El avance del terreno
Las entrevistas logradas por semana y su acumulado, comparados con la muestra objetivo de 74.668 viviendas:
avance <- base |>
  filter(grupo == "E") |>
  count(semana) |>
  mutate(acumulado = cumsum(n))

ggplot(avance, aes(semana, acumulado)) +
  geom_line(color = "#0A3564") +
  geom_point(color = "#0A3564", size = 2.5) +
  geom_hline(yintercept = 74668, linetype = "dashed") +
  labs(x = "Semana de terreno", y = "Entrevistas logradas acumuladas") +
  theme_minimal()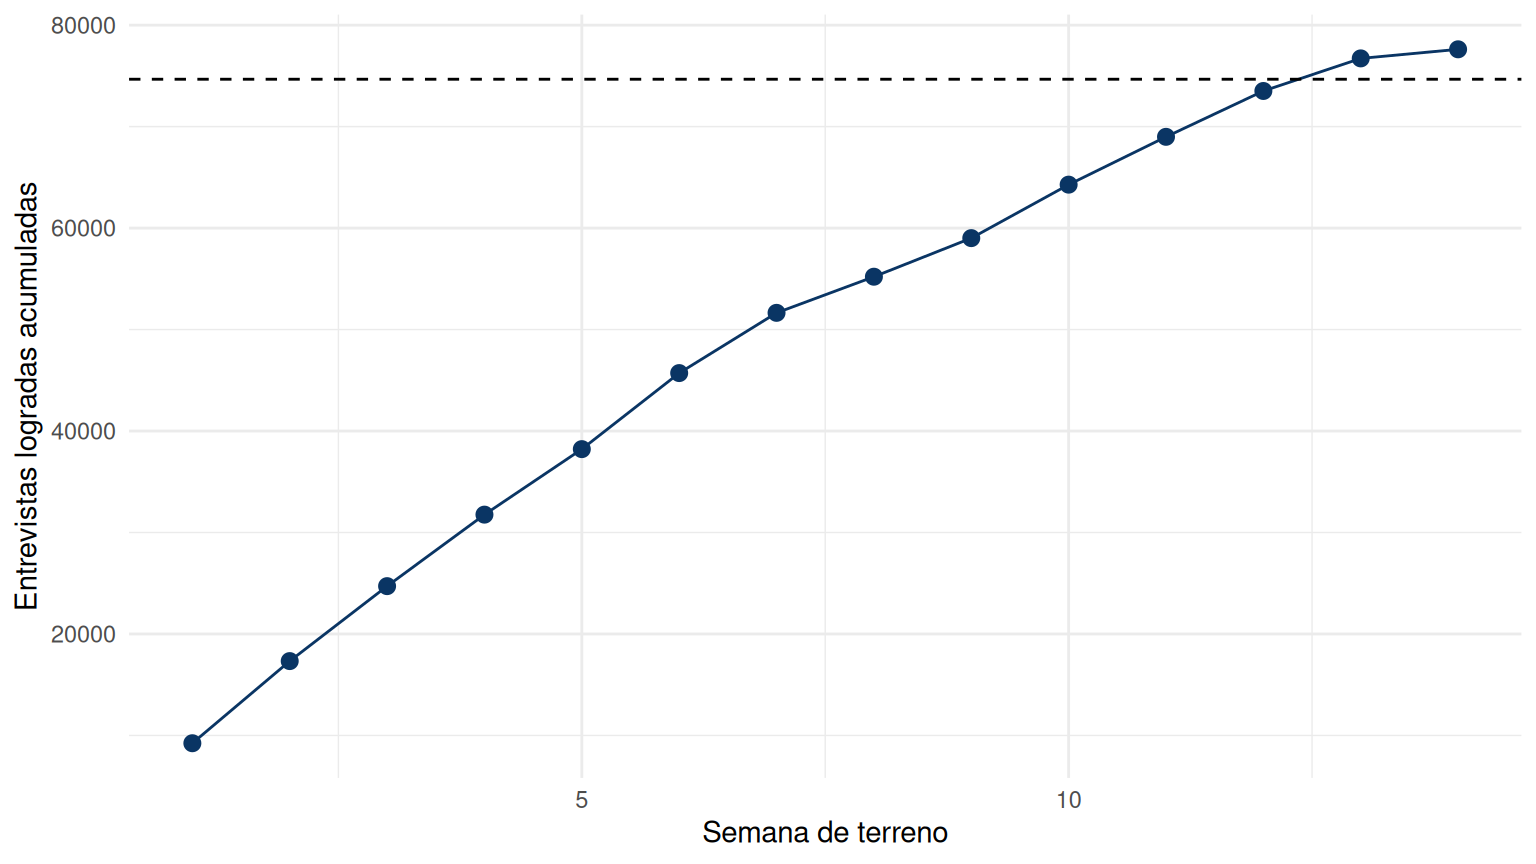
Y dos indicadores de esfuerzo:
# Promedio de visitas según el resultado final
base |>
  filter(grupo != "SG") |>
  group_by(grupo) |>
summarise(visitas_promedio = round(mean(n_visitas), 2))| grupo | visitas_promedio |
|---|---|
| E | 2.06 |
| ED | 2.61 |
| NC | 4.57 |
| NE | 1.37 |
| O | 1.89 |
| R | 3.00 |
# Encuestadoras activas por semana (con al menos una entrevista lograda)
base |>
  filter(grupo == "E") |>
  group_by(semana) |>
summarise(activas = n_distinct(id_encuestador))| semana | activas |
|---|---|
| 1 | 1256 |
| 2 | 1132 |
| 3 | 1049 |
| 4 | 987 |
| 5 | 938 |
| 6 | 901 |
| 7 | 820 |
| 8 | 646 |
| 9 | 665 |
| 10 | 680 |
| 11 | 656 |
| 12 | 619 |
| 13 | 556 |
| 14 | 436 |
¿En qué semana se alcanzó la muestra objetivo? ¿Qué pasa con el número de encuestadoras activas a medida que avanza el terreno? ¿Cuánto esfuerzo consumieron los casos que nunca se lograron?
Paso 7. Indicadores por encuestadora
El monitoreo también mira a cada encuestadora. Como ejemplo, la tasa de cooperación de cada una en todo el terreno. Se consideran solo las que cerraron al menos 30 casos, porque con pocos casos una tasa varía mucho por azar:
por_encuestadora <- base |>
  filter(grupo != "SG") |>
  group_by(region = as_factor(region), id_encuestador) |>
  summarise(
    casos = n(),
    E = sum(grupo == "E"),
    R = sum(grupo == "R"),
    O = sum(grupo == "O"),
    .groups = "drop"
  ) |>
  filter(casos >= 30) |>
  mutate(cooperacion = round(100 * E / (E + R + O), 1))

nrow(por_encuestadora)
[1] 1198Cada encuestadora trabaja en una sola región, así que conviene compararla con las demás de su región. Un gráfico de cajas por región muestra la distribución: la caja va del percentil 25 al 75, y los puntos sueltos son las encuestadoras que se alejan más de 1,5 veces el rango intercuartílico.
ggplot(por_encuestadora, aes(cooperacion, region)) +
  geom_boxplot(color = "#0A3564", outlier.size = 2) +
  scale_y_discrete(limits = rev) +
  labs(x = "Tasa de cooperación por encuestadora (%)", y = NULL) +
  theme_minimal()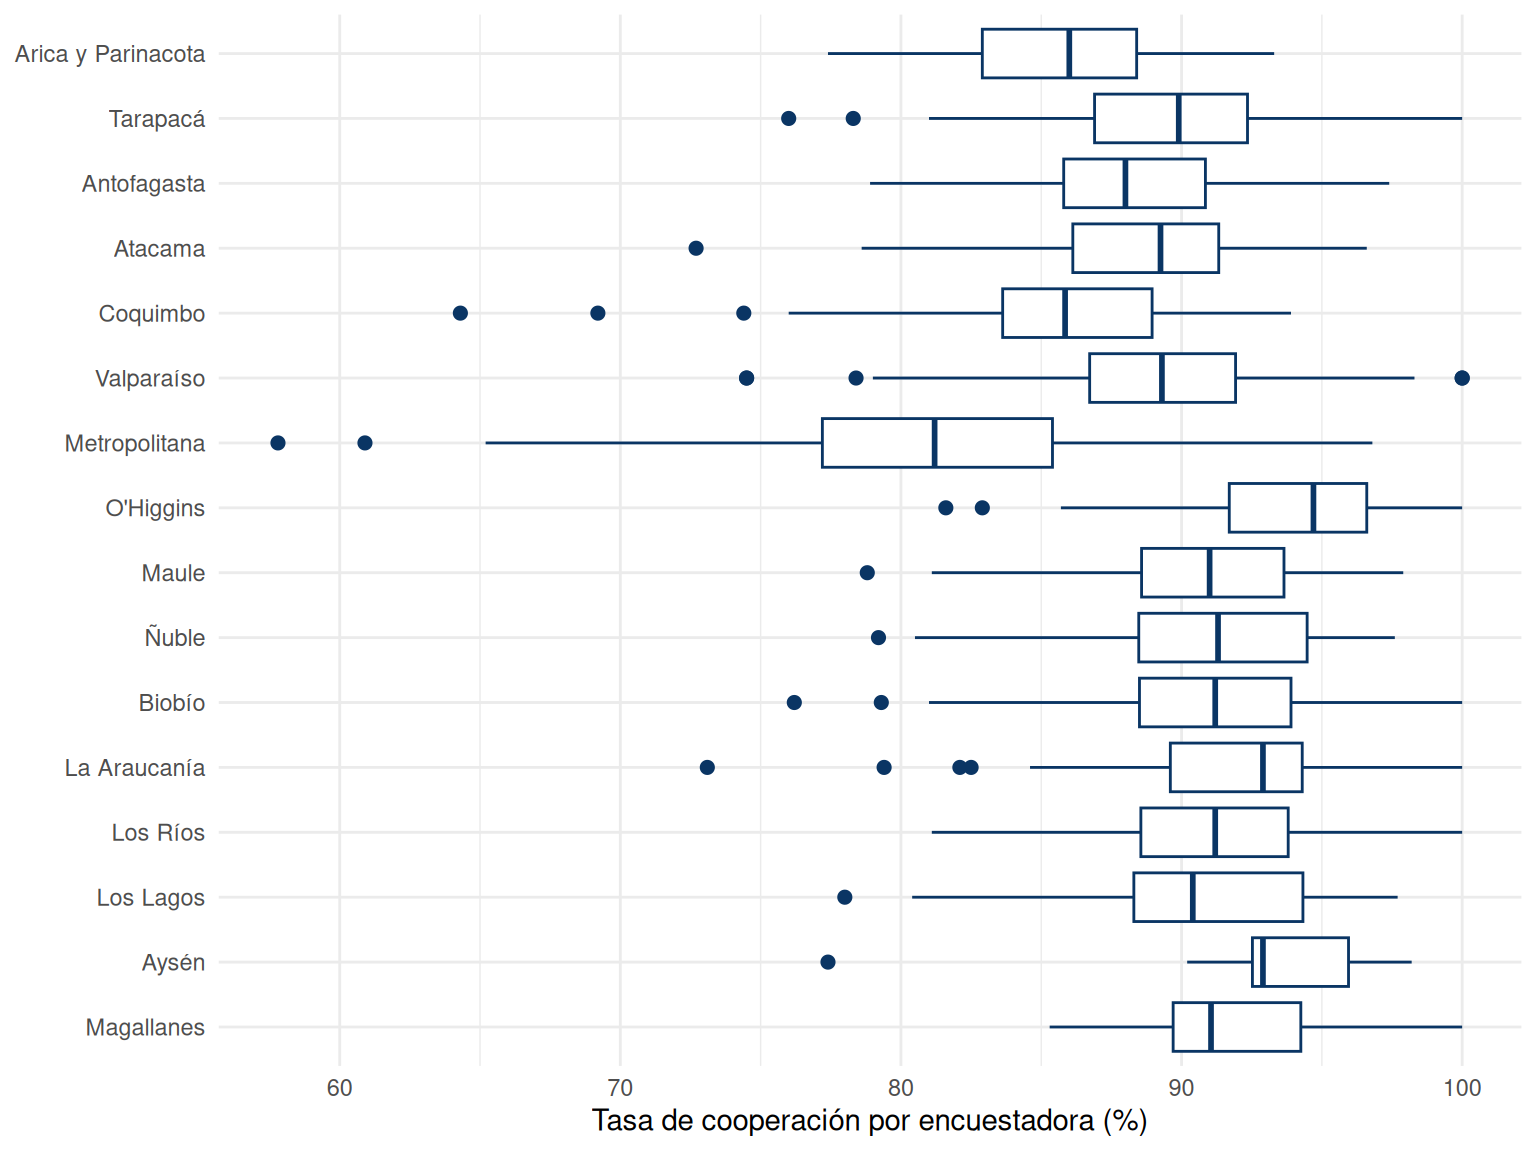
La misma regla permite listar a las encuestadoras atípicas por abajo dentro de su región:
por_encuestadora |>
  group_by(region) |>
  mutate(limite = round(quantile(cooperacion, 0.25) - 1.5 * IQR(cooperacion), 1)) |>
  filter(cooperacion < limite) |>
select(region, id_encuestador, casos, cooperacion, limite)| region | id_encuestador | casos | cooperacion | limite |
|---|---|---|---|---|
| Tarapacá | ENC1690 | 36 | 78.3 | 78.7 |
| Tarapacá | ENC1702 | 40 | 76.0 | 78.7 |
| Atacama | ENC1609 | 65 | 72.7 | 78.3 |
| Coquimbo | ENC1600 | 32 | 69.2 | 75.6 |
| Coquimbo | ENC1652 | 32 | 64.3 | 75.6 |
| Coquimbo | ENC1671 | 51 | 74.4 | 75.6 |
| Valparaíso | ENC1439 | 115 | 78.4 | 78.9 |
| Valparaíso | ENC1534 | 60 | 74.5 | 78.9 |
| Valparaíso | ENC1592 | 74 | 74.5 | 78.9 |
| Metropolitana | ENC1602 | 75 | 60.9 | 64.9 |
| Metropolitana | ENC1606 | 74 | 57.8 | 64.9 |
| O’Higgins | ENC0479 | 49 | 82.9 | 84.4 |
| O’Higgins | ENC1595 | 67 | 81.6 | 84.4 |
| Maule | ENC1502 | 93 | 78.8 | 81.0 |
| Ñuble | ENC1721 | 60 | 79.2 | 79.5 |
| Biobío | ENC0093 | 32 | 79.3 | 80.4 |
| Biobío | ENC1587 | 53 | 76.2 | 80.4 |
| La Araucanía | ENC1424 | 31 | 82.1 | 82.5 |
| La Araucanía | ENC1683 | 38 | 73.1 | 82.5 |
| La Araucanía | ENC1703 | 59 | 79.4 | 82.5 |
| Los Lagos | ENC1550 | 64 | 78.0 | 79.3 |
| Aysén | ENC1201 | 33 | 77.4 | 87.4 |
¿Cuántas encuestadoras quedan marcadas? Con más de mil encuestadoras, ¿cuántas esperarían marcar solo por azar? ¿Qué otra información necesitarían para decidir si una de ellas tiene un problema real?
Fuentes
- AAPOR (2023). Standard Definitions: Final Dispositions of Case Codes and Outcome Rates for Surveys (10.ª ed.).
- Observatorio Social, Ministerio de Desarrollo Social y Familia (2026). Documento metodológico del proceso estadístico Casen 2024. Tablas 20 a 23, gráficos 2 y 3, y Anexo 1.